Mostrando las entradas con la etiqueta testability. Mostrar todas las entradas

sábado, 25 de mayo de 2013

Principios de diseño de software

El problema fundamental al construir software es conseguir su mantenibilidad en el tiempo, esto es: lograr que el echo de agregarle features o modificarlo, sea lo más fluido posible con pocos contratiempos ni grandes dolores de cabeza (casi una utopía?).
Parece ser que una de las causas es la poca claridad en los requerimientos definidos por el cliente quien muchas veces es exigente pero muy laxo en cuánto a expresar qué es lo que pretende del software que necesita. Eso provoca la falta de claridad en los requerimientos lo cual motiva que muchas decisiones sobre la interpretación del dominio queden en manos de los desarrolladores quienes tienen que imaginar (inclusive pueden llegar a recrear en su cabeza una imagen mítica de un Owner que jamás vieron :) ) cómo serian las cosas en el negocio del cliente, pero hagámonos la idea que tendríamos que ponernos como “expertos del negocio” y comenzar definir cosas (podríamos hacerlo muy bien?). Ojo que esto no tiene que ver con ponerle limites al cliente respecto a lo técnico, sino que me refiero a que él debería ayudar a definir lo mejor posible los requisitos sino nos veremos en problemas a largo plazo.
Por otro lado, la otra causa es que en general , ya sea por falta de skills, porque no hay ganas, porque no queremos poner “cabeza” (lo cual suele pasar), porque estamos en modo “conformistas” o por lo que sea no respetamos lo que se conocen como “Principios de Diseño” los cuales son guías y hasta patrones que nos dicen, en un mundo OO, cómo deberíamos organizar y escribir nuestras clases, métodos, propiedades con el fin de que la mantenibilidad vea la luz.
Por decirlo de otro modo: existen unos cuantos principios (recomendaciones) que si son apropiada y extensivamente aplicados transformarían una pieza de código en una manejable y flexible.
Es importante demarcar que este tipo de código que carece signos claros de un diseño inteligente junto con comportamientos y datos duplicados además de el conocido código spaguetti, se conoce como la Gran Bola de Barro (Big Ball of Mud).
Los síntomas usuales de que tenemos una Gran Bola de Barro son estos:
  1. Al hacer un cambio en un lugar, se rompe el código en otra: un cambio en un modulo repercute en cascada hacia otros módulos, lo cual provoca que sea muy difícil predecir el impacto de un cambio.
  2. Fácil de usar pero difícil de reusar: aquí el problema es la cantidad y profundidad de las dependencias inadecuadas entre módulos. Cuando usar un modulo se vuelve complicado, en general se llega a la opción de reescribir el código desde cero (from scratch), porque entenderlo es duro.
  3. Más fácil de aplicar un solución temporal (workaround) que resolver de acuerdo al diseño: un workaround es una solución de compromiso (“después lo arreglamos mejor”) para un problema puntual del software porque hacer una solución (fix) exacta “de acuerdo al diseño” llevaría mucho tiempo (para entender y ver como encajan las piezas).

Principios universales de diseño

Lo usual que todos conocemos desde la facultad, son los patrones GRASP (object-oriented design General Responsibility Assignment Software Patterns) los cuales nos dan las sugerencias básicas sobre cómo asignar responsabilidades (qué debe hacer cada objeto) para un diseño de software adecuado y claro. Estas buenas practicas  son importantes y deberíamos tenerlas en cuenta para lo que sigue.
Dejo un grafico esquemático, no lo vamos a repasar porque se van a ver implícitos en lo que desarrollaremos un poco más adelante, pero vale la pena recordarlos:
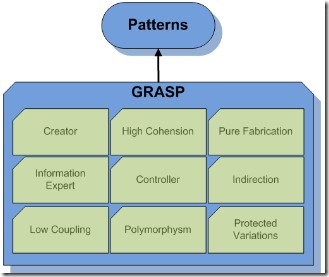
GRASP

Alta Cohesión
La cohesión quiere decir que todo el código de un modulo (entiéndase como una clase o método o un assembly) debe estar lógicamente relacionado. La cohesión se mide de Alto a Bajo y siempre se prefiere que un modulo tenga una Alta Cohesión.
Ejemplo de baja cohesión (indeseable)
   1: List<Proveedor> FindProveedoresByNombre(string nombre)

   2:       {

   3:           var contentXML = System.IO.File.ReadAllText("config.xml");

   4:           //aqui se busca la conexion en el archivo leido;

   5:           var connectionStr = "....";

   6:           SqlConnection sqlConn = new SqlConnection(connectionStr);

   7:           var cmd = sqlConn.CreateCommand();

   8:           cmd.CommandText = "SELECT * from proveedor where nombre like '%" + nombre + "'%";

   9:           var sqlReader=cmd.ExecuteReader();

  10:  

  11:           List<Proveedor> resultados = new List<Proveedor>();

  12:           var counter=0;

  13:           while (sqlReader.Read())

  14:           {

  15:              // mapear objeto de salida

  16:               counter++;

  17:           }

  18:  

  19:           sqlReader.Close();

  20:  

  21:           //Aqui se envia un mail con la cantidad de resultados.

  22:           var body = string.Format("Se encontraron {0} proveedores con nombre'{1}'", counter, nombre);

  23:           mail.Send(body);

  24:  

  25:           return resultados;

  26:       }

Este método como está escrito tiene muy baja cohesión porque su fin es buscar proveedores con un criterio especifico pero hace de todo: busca el archivo de configuración, extrae la cadena de conexión, crea la conexión a la base de datos, elabora la query SQL, ejecuta, mapea y encima envía un mail!!. Pésimo, se pierde totalmente la coherencia porque si bien son tareas que se requieren para buscar un proveedor, estas son demasiadas responsabilidades para un solo método. Imaginemos que después tenemos otro tipo de filtro que requerirá la misma cadena de conexión, entonces vamos a repetir el mismo bloque de código? De eso se trata la alta cohesión: hacer que un método se concentre en una tarea lo mas especifica posible.

Bajo Acoplamiento

El acoplamiento tiene que ver con el grado de dependencia de dos módulos lo cual implica que si A depende excesivamente de B, entonces un cambio en B puede provocar efectos colaterales en A. El acoplamiento dice que que si la superficie de contacto de dos módulos es menor, es mucho mejor. El bajo acoplamiento esta relacionado con el ocultamiento de información y las abstracciones: mientras más ocultos esten sus detalles de implementación y más clara y estables sean sus puntos de contacto con el exterior (interface), menor será el acoplamiento. Es característica es siempre lo deseable.

Ejemplo de alto acoplamiento (indeseable)

   1: class Articulo

   2:    {

   3:        public decimal precio;

   4:        public int cantidad;

   5:        public string descripcion;

   6:    }

   7:  

   8:    class Inventario

   9:    {

  10:        public Articulo[] Articulos;

  11:    }

  12:  

  13:    class InventarioValorado

  14:    {

  15:        private decimal impuesto;

  16:        private Inventario inventario;

  17:  

  18:        public InventarioValorado(decimal _impuesto,Inventario _inventario)

  19:        {

  20:            this.inventario = _inventario;

  21:            this.impuesto = _impuesto;

  22:        }

  23:  

  24:        public decimal CalcularTotal()

  25:        {

  26:            decimal total = 0;

  27:            //esta invadiendo el ocultamiento de los detalles de implementacion.

  28:            foreach (var item in this.inventario.Articulos)

  29:            {

  30:                var subtotal = item.precio * item.cantidad;

  31:                var subtotalConImpuesto = subtotal * (1 + subtotal * (item.cantidad * 0.02m * impuesto));

  32:                total += subtotalConImpuesto;

  33:            }

  34:  

  35:            return total;

  36:        }

  37:    }


En este ejemplo, la clase “InventarioValorizado” tiene un alto acoplamiento a las clases Articulo e Inventario porque depende de sus detalles internos (tiene que saber que guarda en un array los artículos) y además InventarioValorizado esta calculando la valorización de cada articulo (esto debería saberlo el Articulo, no?). Esto es indeseable.

Separación de intereses (SC)

Este principio es clave para conseguir la Alta Cohesión y el Bajo Acoplamiento. La separación de intereses (Separation of Concerns) nos dice que hay que dividir un sistema en features que no se solapen. Lo importante es que cada feature represente un “concern” o “aspecto” de nuestro sistema de manera que disminuyamos considerablemente la duplicación de funcionalidades.  Cada concern se mapea en módulos.

Mencionaré al paper “On  the role of  scientific thought” del prócer de la informática como fue Edsger W. Dijkstra, el ensayo introduce la noción de separación de intereses

SC nos dice que en un momento dado nos concentremos en un aspecto del sistema a la vez, ignorando temporalmente los demás.

SC se consigue a partir de:

Modularidad: cada feature tendrá su propio modulo con una interfaz pública fija y estable con la que se comunicará con otros módulos. Se relaciona con el Ocultamiento de la Información.

Ocultamiento de la información: significa que detrás de una interfaz estable se ocultan detalles, sujetos a variación, sobre cómo esta implementado (programado) un modulo. Así, los módulos se atan a una interfaz fija y no serían afectados por los cambios en la implementación.

Un ejemplo práctico de ocultamiento de la información es el de las propiedades (property) de C#:

Information Hiding with property

Finalmente dejo una observación que es importante y clara: SC induce a la aplicación de la alta cohesión, ya que separar aspectos implica dividir en responsabilidades únicas.


En el siguiente post veremos los Principios SOLID, los que se derivan como una consecuencia de los Principios universales de diseño.
SOLID
Proximo Post...


jueves, 16 de mayo de 2013

TDD (Test Driven Development)

¿Qué entiendo yo por TDD (Test Driven Development)?

TDD es una técnica que nos dice que, antes de construir código que expresa la solución para un requerimiento dado (que es el circuito clásico), expresemos esos requerimientos (de tenor técnico) como pruebas que debería pasar la funcionalidad que vamos construir. En otras palabras: primero decimos cómo se validará nuestro requerimiento a nivel de código antes de escribir ese código que cumplirá ese requerimiento. Muy rarito y a contramano de lo que estamos acostumbrados.
Repito, suena un poco raro, pero tiene un sentido que pasaremos a explicar un poco más adelante.
Como quizás sabemos, si han leído algo sobre el Agilismo en el software, la idea es trabajar lo mas que se pueda con el interesado en el producto o quien sepa del negocio entre manos para poder desentrañar qué es lo que realmente desean con el software: me refiero a saber definir sus requerimientos. En otras palabras, para representar los requerimientos como “pruebas” primero se debe entenderlos. A los requerimientos lo intentamos interpretar nosotros con la ayuda del/los stakeholders si es necesario (para eso el agilismo los hace participar en el equipo de gente que construirá el producto para él). El corolario es que si entendemos mal el requerimiento, inadecuadas también serán las pruebas que escribamos.
La base de TDD son los Unit Test que es el nombre que recibe ese “código” que representa el requerimiento que se validará. Esto es, Unit Test es un “método” que prueba una unidad de trabajo entendiéndose a esta como un método, un conjunto de ellos o una propiedad; la idea es que la unidad de trabajo es un “todo coherente” que ejecuta y da respuesta a nuestro requerimiento.
Vamos a necesitar el requerimiento del usuario, que puede estar expresado como una User Story,  comprendido por nosotros (si no lo entendemos bien deberíamos retroalimentarnos con el owner)  Pero para poder derivar una prueba seria aconsejable tener la Historia de Usuario desglosada en tareas puntuales que nos sirvan de guía para escribir los Unit Test, este trabajo ya es nuestro porque se supone que entendimos aproximadamente bien la Historia.
En TDD usamos ciertos colores para representar las tres fases por las que pasa el trabajo de escribir un Unit Test (UT) y el código que la satisface: Rojo, Verde y Refactoreo.
Los UT los podemos escribir a “mano” completamente o nos valemos de los frameworks disponibles que nos ayudan en un montón de tareas de configuración de manera que nos concentremos en lo que realmente tiene valor lo cual es expresar un requerimiento como una prueba y ejecutarlo.
Vamos a usar el framework que viene con Visual Studio que es el Visual Studio Unit Testing Framework pero también tenemos uno muy bueno como NUnit que es free y open source y sirve para. NET.

Volvamos a las fases de TDD y veamos que son y para qué sirven:
Fases de TDD

Se supone que procedemos así:
Tenemos nuestro requerimiento expresado en algo más operacional para el developer, tenemos más o menos en claro cuál la prueba que necesitamos. Escribimos la prueba con la ayuda de nuestro framework, lo que resultará en un método como cualquier otro solo que en su cuerpo pondremos todo lo necesario para validar lo que le pediremos a nuestro software y lo que este devolverá.
  1. Vamos a comenzar a escribir código y la idea es que inicialmente pase por dos subfases: primero que no compile (porque habrá clases y métodos que no existen todavía) y segundo que deliberadamente no supere la prueba Sonrisa pero siendo ya código compilable. Aquí vamos a ver salir nuestro primer color ROJO porque el framework de UT automáticamente nos avisará que nuestro código no pasa la prueba que le pusimos (pero sí compila). Vamos ser mas claros: armamos nuestro test y ESCRIBIMOS el código que nosotros suponemos que será necesario llamar desde el UT para que esta pase. En resumen: escribimos código  compilable que no pase la prueba es decir el framework de UT nos lo dirá con un color rojo.
  2. Seguidamente escribimos la mínima cantidad de código que nos hará superar la prueba propuesta por el UT. La MINIMA implica escribir lo mas elemental que podamos, así sea código hardcodeado pero que sabemos que superara la prueba. De nuevo, esto suena loco, pero de esta forma obtendremos nuestro primer color VERDE.
  3. Y finalmente cuando ya tenemos nuestro color Verde, vamos a refactorear si es necesario para reorganizar nuestro código teniendo en mente los patrones más usuales así como los code-smells conocidos. “Limpiamos” nuestro código y ejecutamos de nuevo el test automático esperando nos dé un color verde nuevamente. Esto será la señal de que no hay nada más que hacer por ahora con ese UT puntual pues ya lo pasamos.
  4. Luego vamos a nuestra bolsita de “requerimientos refinados” y escogemos el siguiente para aplicarle la misma secuencia de pasos que vimos antes.
La cuestión es que a medida que avanzamos nos vamos a ir dando cuenta que todos los tests van a comenzar a relacionarse de alguna forma o que tal vez hasta necesitemos otros UT para validar otros UT (triangulación). De esta manera nuestro software, dice la metodología TDD, será “guiado” por las pruebas y el diseño surgirá de a poco, paso a paso.
Por otro lado vale aportar que existe toda una discusión sobre si esto es posible, si no será necesario hacer antes un pequeño “boceto” de la funcionalidad, si comenzar con la mente vacía y comenzar a armar paso a paso el diseño como dice crudamente TDD. Es por ello que voy a dejar un link muy interesante sobre esta discusión: Los varios significados de TDD. De mi parte me quedo con la idea de que hay que comenzar con un pequeño esquema mental (algo así como un up-front design pero humilde) antes de desarrollar un requerimiento siguiendo TDD . Después uniendo lo previo con el paso a paso de TDD me parece que funcionaria mejor siendo más accesible.

Ejemplo: Cazando el Wumpus
Voy a construir un pequeño ejemplo que use una vez en una charla interna sobre TDD que di en la empresa donde laburo. La idea es que la funcionalidad es para un jueguito muy primitivo y antiguo (nació en los 70’) que se llama “Atrapando al Wumpus”. La esencia del juego es que tenemos dos players: el monstruo Wumpus, quien está escondido en una cueva, y yo . Por otro lado, tengo que ir aleatoriamente por diferentes cuevas y si me cruzo con el wumpus pierdo, y para eso el sistema me debe pedir a qué cueva deseo ir. Si paso por cinco cuevas sin cruzarme con el Wumpus, gano; de lo contrario pierdo. Esta es la versión más simple de juego y es la que intentare desarrollar lo mejor que pueda con TDD.
La version primitiva del Wumpus (1972!)

Requerimientos:
  1. Dar una posición inicial y aleatoria al Wumpus.
  2. Dar una posición inicial y aleatoria al jugador.
  3. La posición inicial del jugador no debe ser igual a la inicial del Wumpus.
  4. El jugador puede moverse por las diferentes cuevas.
  5. Cada vez que el jugador se ubica en una nueva cueva, cambia de posición el wumpus.
  6. El jugador tiene cinco oportunidades para moverse.
  7. El juego debe informar al jugador en qué cueva está ubicado actualmente.
  8. Si la posición del jugador coincide con la del wumpus, pierde el juego.
  9. Si el jugador nunca se encuentra con el Wumpus, gana.

Creamos el proyecto de Test
Creando un nuevo proyecto de UT
Cómo es una "Prueba" por dentro
Tomamos el primer requerimiento y escribimos el test como lo imaginamos, sin crear las clases necesarias todavía solo escribiendo en el código del UT cuales serian las necesarias (intenciones). En mi caso imagino esto:


   1:  

   2:         [TestMethod]

   3:         public void Wumpus_Tiene_Una_Posicion_IniciaAleatoria()

   4:         {

   5:             //Arrange

   6:             var juego = new Juego();

   7:           

   8:             //Act

   9:             juego.DarPosicionInicial(EnumPlayers.Wumpus);

  10:             var cuevaActual = juego.ObtenerPosicionActual(EnumPlayers.Wumpus);

  11:  

  12:             //Assert

  13:             Assert.IsTrue(cuevaActual.cueva > 0);

  14:         }
Ni Juego, ni la enumeración EnumPlayers, ni los métodos que se llaman de Juego existen todavía físicamente, solamente estoy demarcando cuales son mis “intenciones” respecto a la funcionalidad que necesito. Huelga decir que este código no compila para nada. Si le damos Build veremos esto:

image

Ahora lo que debemos hacer es que esto compile creando las clases, métodos y enumeraciones en el proyecto del Wumpus. Primero hacemos referencia al assembly de nuestro juego desde el proyecto de UT:

image

Y luego en el proyecto del Juego creamos todas las clases, métodos y enumeraciones que pusimos en nuestras “intenciones” en la prueba:

image

Una vez que tenemos código compilable escribimos el mínimo código en la funcionalidad para que NO pase la prueba. Es decir, buscamos el color Rojo. En nuestro caso vemos que podemos dejar como están implementados por defectos los métodos, que lanzan una excepción y con eso ya tenemos nuestro primer Rojo:


   1: public class Juego

   2:    {

   3:        public void DarPosicionInicial(EnumPlayers enumPlayers)

   4:        {

   5:            throw new NotImplementedException();

   6:        }

   7:  

   8:        public Cueva ObtenerPosicionActual(EnumPlayers enumPlayers)

   9:        {

  10:            throw new NotImplementedException();

  11:        }

  12:    }

Probamos el test y vemos el resultado, pero antes de probar debemos por un lado activar o hacer visible el Test Explorer y luego compilar toda la solución para que nuestro test sea detectado por el Test Explorer:

Ejecutar Test, desde Test ExplorerTest no pasa, color ROJO

Ya tenemos el Rojo por lo tanto ahora debemos buscar el Verde escribiendo la mínima cantidad de código para pasar la prueba, veamos:

Codigo mínmo para pasar la prueba

Y voila! Tenemos nuestro primer Verde:

Test Aprobado, Verde

Ahora lo que sigue es refactorear si es necesario lo que escribimos de código y luego volvemos a correr el test, veamos.
A mi se me ocurre que lo que podría refactorear es la propiedad “cueva” que indica la“coordenada de la Cueva, le voy a poner un nombre mas adecuado tal como “Posición”:

Refactoreo

Corremos el test y vemos que seguimos con Verde! Con lo cual sabemos que dejamos por un rato este requerimiento aquí y buscamos otro.

Refactoreo y test Aprobado de nuevo.

Seguimos con los otros requerimientos en otra entrega…to be continue Sonrisa

Links interesantes sobre discusiones sobre TDD y sus implicancias

Model-View-Presenter en ASP.NET Webforms

//coming soon